現代のビジネス環境において、ネットワークは事業継続を支える生命線です。一方で、そのネットワークを標的とするサイバー攻撃は日々高度化・巧妙化しており、ひとたびインシデントが発生すれば、事業停止や信用の失墜といった深刻な損害につながりかねません。このような状況下で、ネットワークの状態を常時把握し、異常をいち早く検知する「ネットワーク監視ツール」の役割は、セキュリティ運用において極めて重要です。
本記事では、大企業のセキュリティ運用担当者に向けて、ネットワーク監視ツールが持つセキュリティ機能やインシデント対応への活用法、そして自社に最適なツールを選定するための基準を具体的に解説します。
ネットワークセキュリティ監視の課題と重要性
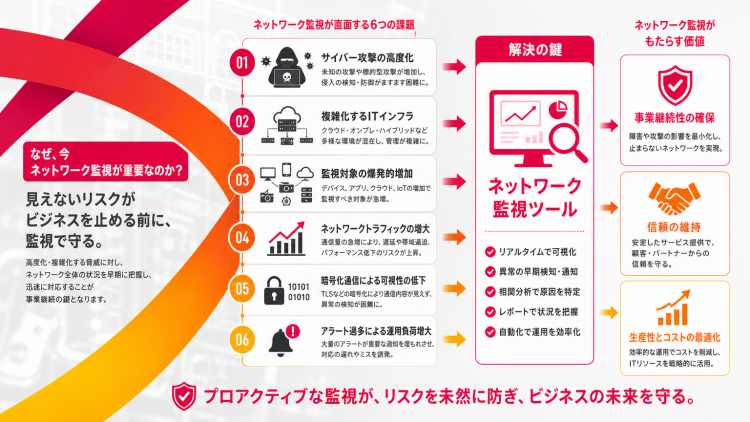
ネットワークセキュリティ監視の重要性は、サイバー攻撃の高度化とITインフラの複雑化により増大していますが、現場では監視対象の爆発的な増加やアラートの大量発生といった多くの課題が存在します。
独立行政法人情報処理推進機構(IPA)が発表した「情報セキュリティ10大脅威 2026」においても、「ランサム攻撃による被害」が11年連続で組織向け脅威の上位に位置し、依然として深刻なリスクであることが示されています。さらに、「サプライチェーンや委託先を狙った攻撃」や、初登場で3位となった「AIの利用をめぐるサイバーリスク」など、攻撃手法は多様化の一途をたどっています。
このような脅威から組織を守るためには、プロアクティブなネットワーク監視が不可欠です。しかし、セキュリティ運用の現場では、多くの課題が存在します。
まず、クラウドサービスの普及やIoTデバイスの増加により、監視対象が爆発的に増加し、それに伴いネットワークを流れるトラフィック量も増大しています。これにより、すべての通信を詳細に把握することが困難になっています。
また、多くの通信が暗号化されているため、SSL/TLSインスペクションなどの対策を講じなければ、暗号化通信に隠れた脅威の可視性が低下してしまいます。さらに、ファイアウォール(FW)、侵入検知システム(IDS/IPS)、エンドポイント検知・対応(EDR)など、セキュリティ製品が機能ごとに細分化しているため、それぞれの製品から膨大なアラートが発生します。
このアラートの大量発生は、セキュリティオペレーションセンター(SOC)担当者の運用負荷を大幅に増大させ、本当に重要な脅威を見逃す「アラート疲労」を引き起こす原因となっています。
ネットワーク監視ツールとは
ネットワーク監視ツールとは、ネットワーク機器やサーバを流れる通信(トラフィック)の状態を継続的に収集・分析し、稼働状況やパフォーマンス低下、セキュリティ上の脅威を可視化・検知するシステムです。障害の予兆検知や迅速な復旧といった運用面の目的から、サイバー攻撃の早期発見やインシデント発生後の原因追究といったセキュリティ面の目的まで幅広くカバーします。
関連するツールとの役割の違い
ネットワーク監視関連ツールは、通信の遅延や障害を防ぐ「稼働管理領域(ネットワーク監視・NMS)」と、サイバー攻撃や内部不正を検知・防護する「セキュリティ領域(セキュリティ監視・IDS/IPS・SIEM)」に大別されます。それぞれのツールが担当する目的とデータの違いは以下の通りです。
| 分類・ツール名 | 主な目的 | 監視対象・扱うデータ | 役割と主な特徴 |
| ネットワーク監視 | ネットワークの稼働維持とパフォーマンスの確保 | 通信状態、応答速度、帯域使用量 | Ping(死活監視)やSNMPを用いて遅延や機器障害の予兆を捉え、安定稼働を保つ。 |
| ネットワークセキュリティ監視 | 不正アクセスや脅威のリアルタイム検出 | パケット、フロー情報(NetFlow/sFlow)、通信パターン | 通信データや挙動を解析し、AI・機械学習を用いた異常検知や振る舞い分析で未知の脅威・内部不正を特定する。 |
| NMS (Network Management System) | ネットワーク機器群の一元管理と統合運用 | ルーター、スイッチ等の機器状態、構成情報、トポロジ | ネットワーク全体の構成・性能・障害を一元的に可視化・管理するプラットフォーム。 |
| IDS / IPS (侵入検知 / 侵入防止システム) | 不正侵入の検知およびリアルタイム遮断 | ネットワーク上を流れる通信データ(インライン/ミラーリング) | シグネチャやルールに基づき、不正な通信を検知(IDS)または即時に自動遮断(IPS)する。 |
| SIEM (Security Information and Event Management) | 組織全体のログ統合分析とインシデント特定 | FW、プロキシ、サーバ、ネットワーク機器等の各種ログ | 膨大なログを一元集約して相関分析を行い、攻撃経路の特定やフォレンジック調査(証拠保全)を行う。 |
ネットワーク監視ツールの機能と特徴
ネットワーク監視ツールは、ITインフラの安定運用に加え、複雑化するサイバー脅威や内部不正を防ぐセキュリティの要として欠かせない存在です。従来のパターンマッチングでは検知が難しい高度な攻撃に対抗するため、AIを用いた振る舞い分析やリアルタイムの可視化など多角的な機能を備えています。ここでは、監視ツールが持つ代表的な機能とその概要、導入によって得られる具体的なセキュリティ上のメリットを解説します。
| 機能名 | 概要 | セキュリティ上のメリット |
| 異常検知と振る舞い分析 | AI/機械学習で平常時のパターンを学習し、逸脱する動きを検知 | 未知の脅威や内部不正の兆候を早期発見、ゼロデイ攻撃対策 |
| ログ収集・分析 | ネットワーク機器のログを一元収集・相関分析 | 攻撃経路の特定、インシデント後のフォレンジック調査、証拠保全 |
| 脆弱性管理連携 | 監視ツールと脆弱性管理システムを連携し、リスクを紐付け | 現実の脅威にさらされている脆弱性を特定し、対応の優先順位付け |
| トラフィック可視化 | 通信量、プロトコル、宛先などをリアルタイムでグラフィカルに表示 | 不審な通信や帯域異常の即時把握、DDoS攻撃の予兆検知 |
異常検知と振る舞い分析による潜在的脅威の早期発見
AI・機械学習を活用した異常検知と振る舞い分析は、未知の脅威や内部不正の兆候を早期に特定する上で極めて有効な機能です。この技術は、平常時のネットワーク通信のパターン(ベースライン)を学習し、そこから逸脱する異常な振る舞いを自動で検知します。
例えば、通常ではありえない深夜のサーバ間通信、従業員による大量のデータアップロード、マルウェア特有のC2サーバとの不審な通信などを捉えることが可能です。シグネチャベースの検知では見逃してしまうゼロデイ攻撃や、内部関係者による意図的な情報持ち出しなど、従来の対策では発見が困難だった潜在的脅威の兆候をプロアクティブに検知し、インシデントを未然に防ぐことにつながります。
ログ収集・分析による攻撃経路の特定とフォレンジック
大量のネットワークログを効率的に収集・分析する機能は、攻撃経路の特定とインシデント後のフォレンジック調査において中心的な役割を果たします。
ファイアウォール、プロキシ、ルーター、スイッチなど、ネットワーク上のさまざまな機器から出力される膨大なログを一元的に集約し、相関分析を行うことで、攻撃者がどのように侵入し、内部でどのように活動を広げたか(ラテラルムーブメント)という一連の流れを時系列で追跡できます。
これにより、インシデントの全体像を正確に把握し、被害範囲の特定や原因究明を迅速化します。収集したログデータは、法的な証拠(デジタル・フォレンジック)としても活用され、インシデント対応の信頼性を高める上で不可欠な情報基盤となります。
脆弱性管理システムとの連携によるリスク優先順位付け
ネットワーク監視ツールと脆弱性管理システムを連携させることは、検出された脅威と既知の脆弱性を紐付け、対応すべきリスクの優先順位を決定する上で非常に効果的です。
脆弱性スキャナが特定した「システムに存在する脆弱性」の情報と、ネットワーク監視ツールが検知した「その脆弱性を悪用しようとする実際の攻撃通信」の情報を突き合わせることで、机上の脆弱性評価だけでは判断できない、現実の脅威にさらされている脆弱性を特定できます。
これにより、セキュリティチームは限られたリソースを、最も危険度の高い脆弱性の修正に集中させることが可能となり、より効率的かつ効果的なリスク管理が実現します。
トラフィック可視化による不正通信のリアルタイム把握
ネットワーク内のトラフィックを詳細に可視化する機能は、不審な通信や帯域の異常をリアルタイムで把握し、セキュリティリスクを評価する上で重要です。
NetFlowやsFlowといったフロー情報を分析したり、パケットキャプチャを行ったりすることで、「誰が(どのIPアドレスが)」「誰と(どの宛先に)」「どのような通信(プロトコルやポート)を」「どの程度の通信量」を行っているかを直感的なダッシュボードやマップで表示します。
これにより、通常では考えられない国への通信、業務外アプリケーションによる帯域の占有、DDoS攻撃の予兆となるトラフィックの急増などを即座に把握できます。セキュリティ担当者は、この可視化された情報を基に、通信の異常性を迅速に判断し、次の調査や対応アクションへとつなげることができます。
インシデント発生時の初動と復旧を早める監視ツールの活用法
ネットワーク監視ツールは、アラートの最適化、状況把握の迅速化、初動対応の自動化、根本原因分析といった活用法により、インシデント対応サイクル全体を効率化し、ビジネスへの影響を最小限に抑えます。
検知(Detection)からトリアージ(Triage)、封じ込め(Containment)、原因調査(Investigation)、復旧(Recovery)、そして再発防止(Post-incident Activity)という一連のプロセスにおいて、監視ツールから得られる情報を最大限に活用することで、対応の迅速化と高度化を実現できます。ここでは、各フェーズにおける具体的な活用法を紹介します。
アラート通知の最適化と担当者へのエスカレーション
アラート通知を最適化し担当者へ自動的にエスカレーションする仕組みを構築することで、対応が必要な重大インシデントを迅速に見つけ出し、対応の遅れを防ぎます。
インシデント対応の初動において最も重要なのは、大量のアラートの中から本当に対応が必要な重要インシデントを迅速に見つけ出すことであり、ネットワーク監視ツールでは、アラートの重要度(クリティカル、重要、警告など)に応じた通知ルールの設定が可能です。
例えば、特定のサーバからの異常なアウトバウンド通信や、既知の脆弱性を狙った攻撃パターンが検知された場合にのみ、最高レベルのアラートを発報させるといったチューニングを行います。
さらに、アラートの内容に応じて、適切な担当者やチーム(サーバ担当、ネットワーク担当、セキュリティ担当など)へメールやチャットツールを通じて自動的にエスカレーションする仕組みを構築することで、担当者の確認漏れや対応の遅れを防ぎ、迅速な初動体制を確立できます。
迅速な情報収集と状況把握のためのダッシュボード活用
インシデント対応専用のダッシュボードを活用することで、関係者は必要な情報を一元的に、かつリアルタイムで把握し、的確な対応策を迅速に立案できます。
インシデント発生時には、関係者が正確な情報を共有し、迅速に状況を把握することが不可欠であり、ネットワーク監視ツールが提供するダッシュボードはこの情報共有と状況把握を強力に支援します。インシデント対応専用のダッシュボードをあらかじめ設計しておき、攻撃元IPアドレス、攻撃対象のサーバ、検知された攻撃の種類、影響範囲、時系列でのイベント発生状況など、意思決定に必要な情報を一元的に表示させます。
これにより、SOCアナリストやインシデント対応チームは、複数の管理画面を切り替えることなく、インシデントの全体像を俯瞰的に、かつリアルタイムで把握でき、的確な対応策の立案を迅速に行うことが可能になります。
自動化連携による隔離・遮断などの初動対応
SOAR(Security Orchestration, Automation and Response)プラットフォームなどと連携して初動対応を自動化することで、マルウェア感染端末の隔離や不正通信の遮断を迅速かつ確実に行い、被害拡大を防ぎます。検知した脅威に対して、迅速に封じ込め措置を講じることは被害拡大を防ぐ上で極めて重要であり、ネットワーク監視ツールを連携させることでこの対応を自動化できます。
例えば、マルウェア感染が疑われる端末からの不審な通信を検知した場合、あらかじめ定義されたプレイブックに基づき、自動的にその端末をネットワークから論理的に隔離したり、ファイアウォールのルールを変更して不正な宛先への通信を遮断したりする、といった対応が可能です。
人手を介さずに自動かつ迅速に対応することで、攻撃者が内部で活動を拡大する時間を奪い、インシデントの封じ込めを迅速かつ確実に行えます。
根本原因分析と再発防止に向けたデータ活用
ネットワーク監視ツールに蓄積された長期間のログデータを活用して根本原因を分析し、具体的な再発防止策を策定することで、組織全体のセキュリティレベルを継続的に向上させます。
インシデントが収束した後、その経験を次に活かすためには、詳細なログ分析による根本原因の特定と効果的な再発防止策の立案が欠かせず、ツールに蓄積されたデータは、このプロセスにおける貴重な情報源となります。インシデント発生時点だけでなく、その前後の通信記録を詳細に分析することで、攻撃の最初の侵入経路はどこだったのか、どの脆弱性が悪用されたのか、他に同様のリスクを抱える箇所はないか、といった根本原因を深く掘り下げて特定できます。
この分析結果に基づき、セキュリティポリシーの見直し、ファイアウォールルールの強化、脆弱性へのパッチ適用といった具体的な再発防止策を策定し、組織全体のセキュリティレベルを継続的に向上させていくことができます。
ネットワーク監視ツールの選定基準
最適なネットワーク監視ツールを選定するには、スケーラビリティ、既存インフラとの統合性、運用負荷、サポート体制といった基準を総合的に評価することが重要です。自社の大規模かつ複雑なネットワーク環境に適したツールを選定するには、機能の豊富さだけでなく、これらの評価基準を基に判断する必要があり、特に大企業では、将来の事業拡大も見据えた長期的な視点での選定が求められます。ここでは、ツール選定における主要な基準を解説します。また、市場にはさまざまな特徴を持つツールが存在します。
商用ツールとオープンソース(OSS)の比較
ネットワーク監視ツールは、大きく「商用ツール」と「オープンソースソフトウェア(OSS)」に分類でき、それぞれにメリット・デメリットがあります。商用ツールは、一般的に導入・運用コストがかかるものの、ベンダーによる手厚い技術サポート、洗練されたUI、導入後すぐに使えるテンプレートなどが提供されるため、専門知識が豊富な人材が限られている場合に適しています。
一方、オープンソース(OSS)は、ライセンス費用が無料である点が最大の魅力です。ソースコードが公開されているためカスタマイズ性が非常に高く、自社の環境に最適化できますが、導入や運用には高度な専門知識が求められ、トラブル発生時も自力での解決が基本となります(有償の商用サポートを提供する企業も存在します)。
自社の技術力、予算、求めるサポートレベルを総合的に考慮し、どちらが最適かを選択することが重要です。
ネットワーク監視ツール選定の重要基準と考慮事項
| 選定基準 | 具体的な考慮事項 | 選定時のポイント |
| スケーラビリティ | 監視対象デバイス数、トラフィック量、将来的な拡張性 | 大規模環境や成長に合わせて柔軟に対応できるか |
| 既存インフラとの統合性 | 既存のSIEM/EDR、クラウド環境、オンプレミス環境との連携 | 既存システムとのシームレスな連携で運用効率を高められるか |
| 運用負荷 | アラートの精度、ダッシュボードの使いやすさ、自動化機能 | SOC担当者の負担を軽減し、アラート疲労を防げるか |
| ベンダーのサポート体制 | 日本語サポートの有無、対応時間、導入・運用支援、セキュリティ情報提供 | 導入後のトラブル対応や継続的なセキュリティ強化を支援してくれるか |
スケーラビリティとパフォーマンス要件
ツール選定においては、膨大な監視データやトラフィック量に対応できる高いスケーラビリティとパフォーマンスが求められます。
大企業のネットワークは、拠点数、デバイス数、データセンターの規模が大きく、生成されるデータ量も膨大であるため、選定するツールには、数万単位の監視項目や高いデータ処理レートに耐えうる性能が必要です。将来的な事業拡大やM&Aによるネットワーク統合も見据え、監視対象が増加してもパフォーマンスが劣化しないアーキテクチャであるかを確認することが重要です。
分散監視機能や、負荷に応じて処理能力を拡張できるスケールアウト構成に対応しているかどうかが、重要な評価ポイントとなります。
既存のセキュリティインフラとの統合性
SIEMやEDRなど既存のセキュリティインフラとシームレスに統合できるかは、セキュリティ運用全体の効率化を図る上で極めて重要な選定ポイントです。
ネットワーク監視ツールは、単体で機能するだけでなく、既存のインフラ全体と連携することでその価値を最大化するため、各種システムとAPIなどを通じて統合できるかを確認する必要があります。
これにより、組織全体のセキュリティ情報を一元的に管理・分析し、インシデント対応プロセス全体を自動化・効率化するエコシステムを構築できます。選定時には、利用中の製品との連携実績や、標準的なAPIの提供有無を確認する必要があります。
運用負荷と管理の容易さ
直感的なGUIや設定の自動化など、管理が容易で運用負荷の低いツールを選ぶことが、継続的な運用を成功させる鍵となります。高機能なツールであっても、設定や管理が複雑で専門的な知識を要する場合、導入後の運用負荷が増大し、かえってセキュリティレベルの低下を招く恐れがあるため、管理の容易さは重要な評価基準です。
特にManageEngine OpManagerのようなツールは、使いやすさに定評があります。日々の運用を担う担当者のスキルレベルを考慮し、トレーニングコストを抑え、属人化を防ぐことができるツールを選ぶことが、継続的な運用を成功させる鍵となります。
サポート体制とベンダーの信頼性
万一のトラブルに備え、迅速かつ的確なサポート体制が提供されているか、またベンダーの技術力や事業継続性といった信頼性も重要な評価基準です。ネットワーク監視は、企業の事業継続に直結するミッションクリティカルなシステムであり、監視ツール自体にトラブルが発生した場合、迅速かつ的確なサポートが受けられるかは非常に重要です。
ベンダーのサポート体制(対応時間、対応言語、技術レベル)を事前に確認することは必須です。また、サイバー脅威の進化に合わせてツールが継続的にアップデートされるか、将来的な技術トレンドに対応するロードマップが明確かなど、ベンダーの技術力や事業の継続性、信頼性も評価する必要があります。
オープンソースソフトウェア(OSS)のZabbixなどを利用する場合は、商用サポートを提供する企業の活用も選択肢となります。
ツール選定における失敗事例と教訓
ツールの選定を誤ると、期待した効果が得られないばかりか、かえって運用負荷を増大させる結果になりかねません。ここでは、よくある失敗事例から教訓を得て、自社の選定に活かしましょう。
失敗事例1:機能過多な高額ツールを導入し、コストだけが増大
将来性を見越して多機能で高額なツールを導入したものの、現場のスキルが追いつかず、基本的な監視機能しか使われないケースです。結果として、ほとんどの機能が死蔵され、高額なライセンス費用だけが経営を圧迫することになります。
【教訓】自社の現状の要件と運用体制を正確に把握し、スモールスタートできるツールを選ぶことが重要です。PoC(概念実証)を通じて、本当に必要な機能と操作性を十分に検証し、身の丈に合った投資を心がけましょう。
失敗事例2:OSS導入でコスト削減のはずが、運用破綻で逆に高コストに
ライセンス費用が無料という魅力からOSSを導入したものの、社内に専門知識を持つエンジニアがおらず、初期構築や継続的なチューニング、トラブル対応に膨大な工数がかかってしまうケースです。結果的に、人件費や機会損失を含めると商用ツールより高くつくこともあります。
【教訓】OSSの導入は、運用を担うチームの技術力や工数を現実的に評価した上で行うべきです。技術力に不安がある場合は、有償の商用サポートの利用を前提に検討するか、導入・運用が容易な商用ツールを選択するのが賢明です。
ネットワーク監視ツールの導入事例
ここでは、ネットワーク監視ツールを導入し、セキュリティ運用を高度化させた企業の事例を2つ紹介します。
事例1:グローバル製造業A社「拠点間のセキュリティガバナンス統一」
- 課題:海外拠点を含む数十拠点のネットワーク機器が個別に管理されており、統一された監視ができていなかった。これにより、インシデント発生時の状況把握に時間がかかり、セキュリティポリシーの徹底も困難だった。
- 解決策:統合監視機能を持つ商用ツールを導入し、国内外の全拠点のファイアウォールやルーターのログ、トラフィック情報を一元的に可視化・分析する基盤を構築した。
- 成果:全拠点のネットワーク状態を単一のダッシュボードでリアルタイムに把握可能になった。これまで見過ごされていた海外拠点からの不審な通信を早期に検知・遮断することに成功。インシデント対応の初動時間が平均で40%短縮され、グローバルレベルでのセキュリティガバナンスが大幅に強化された。
事例2:クラウドネイティブ企業B社「マイクロサービス環境の安定稼働」
- 課題:マイクロサービスアーキテクチャで構成された自社サービスのパフォーマンスが、特定の時間帯に不安定になる問題が発生。しかし、コンテナ間の複雑な通信により、ボトルネックの特定が困難を極めていた。
- 解決策:SaaS型の監視ツールを導入し、各マイクロサービス間の通信量、レイテンシ、エラーレートなどをリアルタイムで監視。特定の通信パターンとパフォーマンス劣化の相関関係を分析した。
- 成果:特定のAPIコールが集中することでデータベース接続が枯渇していた根本原因をわずか数時間で特定。開発チームと運用チームが共通の監視データを見ることで迅速に連携し、対策を講じることができた。これにより、サービスのSLA(サービスレベル合意)を維持し、顧客満足度の向上につながった。
効果的なネットワーク監視ツールの戦略的アプローチ
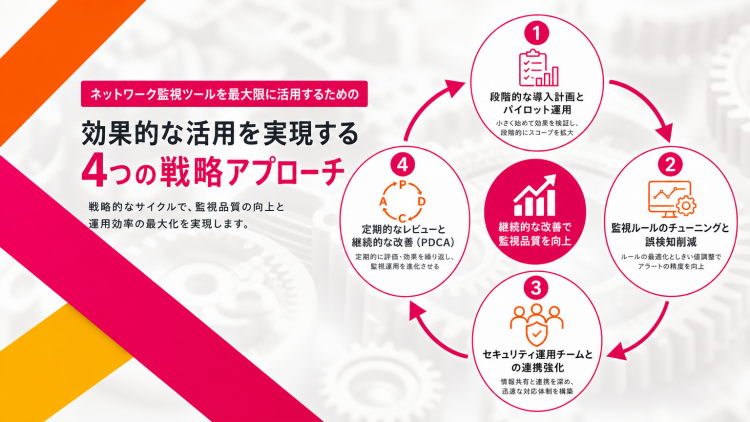
ネットワーク監視ツールの効果を最大化するには、段階的な導入、継続的なチューニング、チーム連携強化、定期的なレビューといった戦略的なアプローチが不可欠です。ツールの導入は、単に製品をインストールして完了するものではなく、その効果を引き出し、組織のセキュリティ体制を継続的に強化するためには、計画から改善に至るまでのプロセスが重要となります。
段階的な導入計画とパイロット運用の重要性
段階的な導入計画を策定し、まずは限定的な範囲でパイロット運用を実施することが、大規模環境への導入を成功させる上で極めて重要です。大規模なネットワーク環境に監視ツールを一斉導入することは、予期せぬトラブルや現場の混乱を招くリスクを伴うため、特定の部門や重要システムなど、スコープを絞って導入し、そこでツールの有効性、パフォーマンス、運用上の課題などを検証します。
このパイロット運用を通じて得られた知見やノウハウを基に、監視設定のテンプレートを作成したり、導入手順を標準化したりすることで、その後の全社展開をスムーズかつ低リスクに進めることができます。
監視ルールのチューニングと誤検知の削減
自社のネットワーク環境や正常な状態(ベースライン)に合わせて監視ルールを継続的にチューニングすることが、アラートの精度を高め、真の脅威に集中できる環境を構築するために不可欠です。導入初期のツールは、デフォルト設定のままでは大量の誤検知アラートを発生させることがあり、これは「アラート疲労」を引き起こし、本当に重要な警告を見逃す原因となります。
どのイベントをアラートとして通知するか、その閾値はどの程度が適切か、といったルールを最適化し、ノイズとなる不要なアラートを削減します。このプロセスを通じて、アラートの精度を高め、セキュリティ担当者が真の脅威に集中できる環境を構築することが、効果的な監視体制の鍵となります。
セキュリティ運用チームとの連携強化
ツールの導入を機に、チーム間の情報共有のプロセスや協力体制を再定義し、連携を強化することが、組織全体のインシデント対応能力を向上させる上で重要です。ネットワーク監視ツールは、監視チームだけでなく、インシデント対応を行うCSIRT(Computer Security Incident Response Team)やSOCなど、複数のセキュリティ運用チームが連携して活用するものであり、円滑な協力体制を確立することで、その効果を最大化できます。
例えば、監視チームが検知したアラートをインシデント対応チームへエスカレーションする際の明確な基準や手順を定める、定期的な合同訓練を実施する、監視ダッシュボードを共有して常に同じ情報を参照できるようにするなど、円滑なコミュニケーションと協力体制を確立することで、組織全体のインシデント対応能力が向上します。
定期的なレビューと継続的な改善
監視体制の有効性を定期的にレビューし、新たな脅威や環境変化に対応するために継続的な改善サイクル(PDCA)を回すことが、持続可能で強固なセキュリティ監視体制を維持するために不可欠です。
ビジネス環境やITインフラ、そしてサイバー脅威は常に変化しているため、一度構築した監視体制が未来永劫有効であるとは限りません。
新しいシステムが導入された際に監視対象に追加されているか、最近の攻撃トレンドに対応した監視ルールが設定されているか、インシデント対応プロセスに改善点はないか、などを定期的に評価します。この継続的な見直しと改善こそが、持続可能で強固なセキュリティ監視体制を維持するための要となります。
まとめ:ネットワーク監視が拓く継続的なセキュリティ運用の未来
本記事で解説したように、ネットワーク監視ツールは、単にネットワーク上の通信やログを可視化するだけでなく、異常の早期検知、インシデント発生時の迅速な状況把握、そして根本原因の分析といった、セキュリティ運用のあらゆる局面で中心的な役割を担います。特に、IT環境が複雑化する大企業においては、増え続ける監視対象やアラートの中から本当に重要な情報を迅速に抽出し、インシデント対応へとつなげる監視体制の構築が、事業継続の生命線となります。
SIEMやEDR、FW、SOARといった既存のセキュリティ基盤とネットワーク監視ツールを連携させることで、脅威の検知から初動対応、復旧、再発防止までの一連のプロセスを大幅に効率化・高度化できます。ツールを選定する際には、機能の多さだけで判断するのではなく、自社のネットワーク規模やトラフィック量に応じたスケーラビリティ、既存システムとの連携性、日々の運用負荷、ベンダーのサポート体制などを総合的に評価することが成功の鍵です。
そして最も重要なのは、ネットワーク監視はツールを導入すれば完了するものではない、という認識です。運用開始後も、自社環境に合わせた監視ルールのチューニングや誤検知の削減、インシデント対応チームとの連携強化、そして定期的な効果検証といった継続的な改善活動が不可欠です。ネットワーク監視ツールをセキュリティ運用の基盤として戦略的に活用することで、インシデントへの迅速な対応はもちろん、潜在的なリスクの早期発見やプロアクティブなセキュリティ運用への転換を実現し、企業のデジタル変革を安全に推進することができるでしょう。
DAIKO XTECHでは企業の社内・社外を含めたセキュリティ環境を守るためさまざまなソリューションを提供しています。